

GPU y Procesamiento Paralelo
Índice
🤖 ¿Qué es una GPU y el Procesamiento Paralelo?
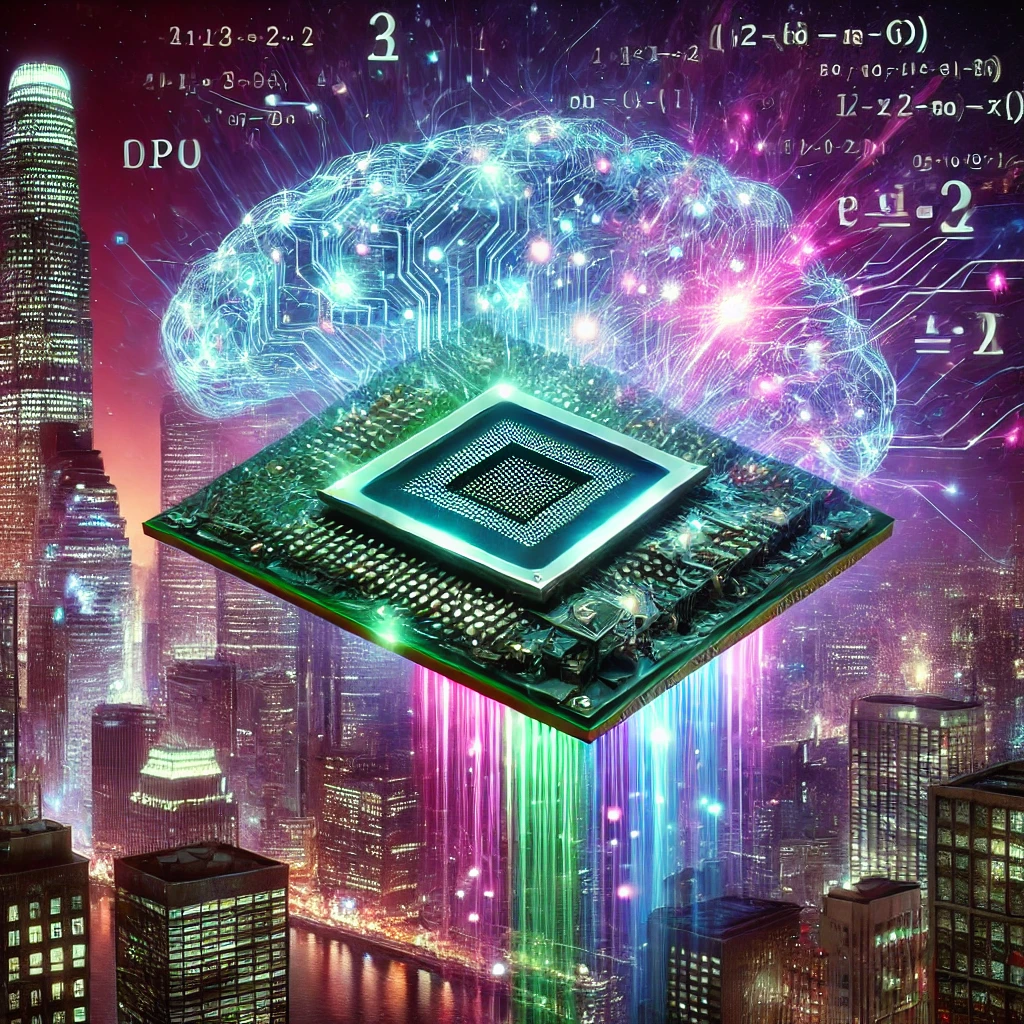
Una GPU (Graphics Processing Unit o Unidad de Procesamiento Gráfico) es un tipo de procesador especializado en realizar cálculos de manera simultánea.
A diferencia de las CPU tradicionales, que están diseñadas para manejar tareas en serie, las GPU pueden ejecutar miles de operaciones en paralelo.
Por eso, son ideales para tareas que requieren un alto rendimiento computacional, como el entrenamiento de modelos de Inteligencia Artificial, simulaciones científicas y procesamiento de grandes volúmenes de datos.
El procesamiento paralelo es la técnica que permite dividir una tarea en varias partes y ejecutarlas simultáneamente en múltiples núcleos de una GPU.
Es decir, esto acelera significativamente el tiempo de cálculo en comparación con una CPU tradicional.
🛠️ ¿Cómo funciona el procesamiento paralelo en GPU?
Las GPU funcionan a través de una arquitectura conocida como SIMD (Single Instruction, Multiple Data), donde una misma instrucción se ejecuta simultáneamente sobre diferentes datos.
Características clave:
- Múltiples Núcleos: Las GPU tienen miles de núcleos pequeños y eficientes.
- Memoria de Alta Velocidad: Diseñadas para manejar grandes volúmenes de datos rápidamente.
- Paralelismo Masivo: Ejecutan muchas operaciones al mismo tiempo.
- Uso en Computación Científica y Deep Learning: Aceleración del procesamiento en modelos de Machine Learning.
Ejemplo de procesamiento paralelo en CUDA
Este es un ejemplo de procesamiento paralelo en CUDA (una plataforma de computación paralela de NVIDIA):
import numpy as np
from numba import cuda

@cuda.jit
def add_kernel(x, y, out):
    idx = cuda.grid(1)  # Obtener el índice del hilo de ejecución
    if idx < x.size:
        out[idx] = x[idx] + y[idx]

# Datos de entrada
N = 100000
x = np.ones(N)
y = np.ones(N)
out = np.zeros(N)

# Copiar a la memoria de la GPU
d_x = cuda.to_device(x)
d_y = cuda.to_device(y)
d_out = cuda.to_device(out)

# Lanzar el kernel en la GPU
threads_per_block = 128
blocks_per_grid = (N + (threads_per_block - 1)) // threads_per_block
add_kernel[blocks_per_grid, threads_per_block](d_x, d_y, d_out)

# Copiar de vuelta a la CPU
out = d_out.copy_to_host()
print(out[:10])  # Ver los primeros resultados
Este código ejecuta la suma de dos arrays en paralelo utilizando CUDA y Numba.
Ejemplo práctico:
Supongamos que queremos entrenar un modelo de Deep Learning con una gran cantidad de datos. Si lo hiciéramos solo con una CPU, tardaría semanas o meses. En cambio, utilizando una GPU, los cálculos matriciales pueden ejecutarse en paralelo, reduciendo el tiempo de entrenamiento a días u horas.
Por ejemplo, en TensorFlow, para aprovechar la GPU:
import tensorflow as tf
print("🔍 Dispositivos disponibles:", tf.config.list_physical_devices('GPU'))
Si se detecta una GPU, TensorFlow la usará automáticamente para acelerar los cálculos.
🚀 ¿Por qué es importante el procesamiento en paralelo?
El uso de GPU y procesamiento paralelo es fundamental en la IA y el Big Data porque:
✅ Reduce el tiempo de procesamiento en entrenamientos de Machine Learning y Deep Learning.
✅ Permite manejar grandes volúmenes de datos de manera eficiente.
✅ Optimiza la computación científica y simulaciones en diversos campos.
✅ Facilita el desarrollo de IA en tiempo real, como el procesamiento de video y la generación de contenido.
🔧 Preguntas Frecuentes
¿Las GPU solo sirven para videojuegos?
No.
Aunque las GPU nacieron para renderizado gráfico en videojuegos, hoy en día se usan ampliamente en inteligencia artificial, big data, minería de criptomonedas y simulaciones científicas.
¿Es necesario tener una GPU para entrenar modelos de IA?
No es obligatorio, pero es altamente recomendable.
De hecho, sin una GPU, los entrenamientos pueden tardar mucho más.
En su lugar, podrías usar servicios en la nube como Google Colab o AWS con GPU disponibles.
¿Todas las GPU sirven para IA?
No.
No todas las GPU están optimizadas para computación paralela en IA.
Es más, las más recomendadas son las de NVIDIA con soporte para CUDA y Tensor Cores.
¿Se pueden usar varias GPU al mismo tiempo?
Sí.
Existen técnicas como multi-GPU y distribución de modelos en plataformas como TensorFlow y PyTorch que permiten entrenar modelos en varias GPU a la vez.
🔗 Relación con otros conceptos clave
- TensorFlow y PyTorch: Librerías populares para Machine Learning que aprovechan GPU.
- CUDA y OpenCL: Tecnologías para programación en GPU.
- Aprendizaje profundo (Deep Learning): Algoritmos que dependen del cálculo paralelo.
- Big Data: Procesamiento de grandes volúmenes de datos con GPUs.
📚 Conclusión
Las GPU y el procesamiento paralelo han revolucionado el mundo de la inteligencia artificial, permitiendo entrenamientos más rápidos y eficientes.
Por eso, si estás desarrollando modelos de Machine Learning, es clave conocer cómo aprovechar la aceleración por GPU.
Si quieres conocer otros artículos parecidos a GPU y Procesamiento Paralelo puedes visitar la categoría Wiki.
¿Cuál es la diferencia entre asistente y agente en IA?
Qué es el mecanismo de atención - Attention Mechanism
Transformers: la arquitectura que revolucionó la IA
LSTM y GRU: Variantes avanzadas de RNN
Subir
Deja una respuesta